Building Neuroclip, Teil 2 von 5. Teil 1: die Architektur · Teil 2: VOD zum Short (du bist hier) · Teil 3: die OBS-Regie · Teil 4: KI-Facecam-Upscaling · Teil 5: Auslieferung auf Kubernetes. Das Produkt selbst findest du auf der Neuroclip-Seite; es ist im Early Access und ich bin bisher der einzige Nutzer.
In Teil 1 habe ich die Form von Neuroclip beschrieben: ein Go-Server, ein React-Dashboard und ein paar kleine Python-Helfer. Dieser Teil begleitet ein Stück Material durch diese Maschinerie: Eine mehrstündige Twitch-Aufnahme geht hinein, ein kurzes Hochformat-Video mit eingebrannten Wort-für-Wort-Untertiteln kommt heraus.
Neuroclip ist ein kommerzielles Produkt, deshalb bleibt dieser Beitrag auf Konzeptebene: die Ideen, die Abwägungen und die allgemeinen Techniken, keine Bauanleitung. ffmpeg und Whisper erledigen die schwere Arbeit. Die Ingenieursarbeit steckt darin, wie ein Go-Programm sie steuert: lang laufende Kindprozesse abbrechbar halten, keine halbfertigen Dateien hinterlassen und dem Spiel, das auf derselben Maschine läuft, nicht im Weg stehen.
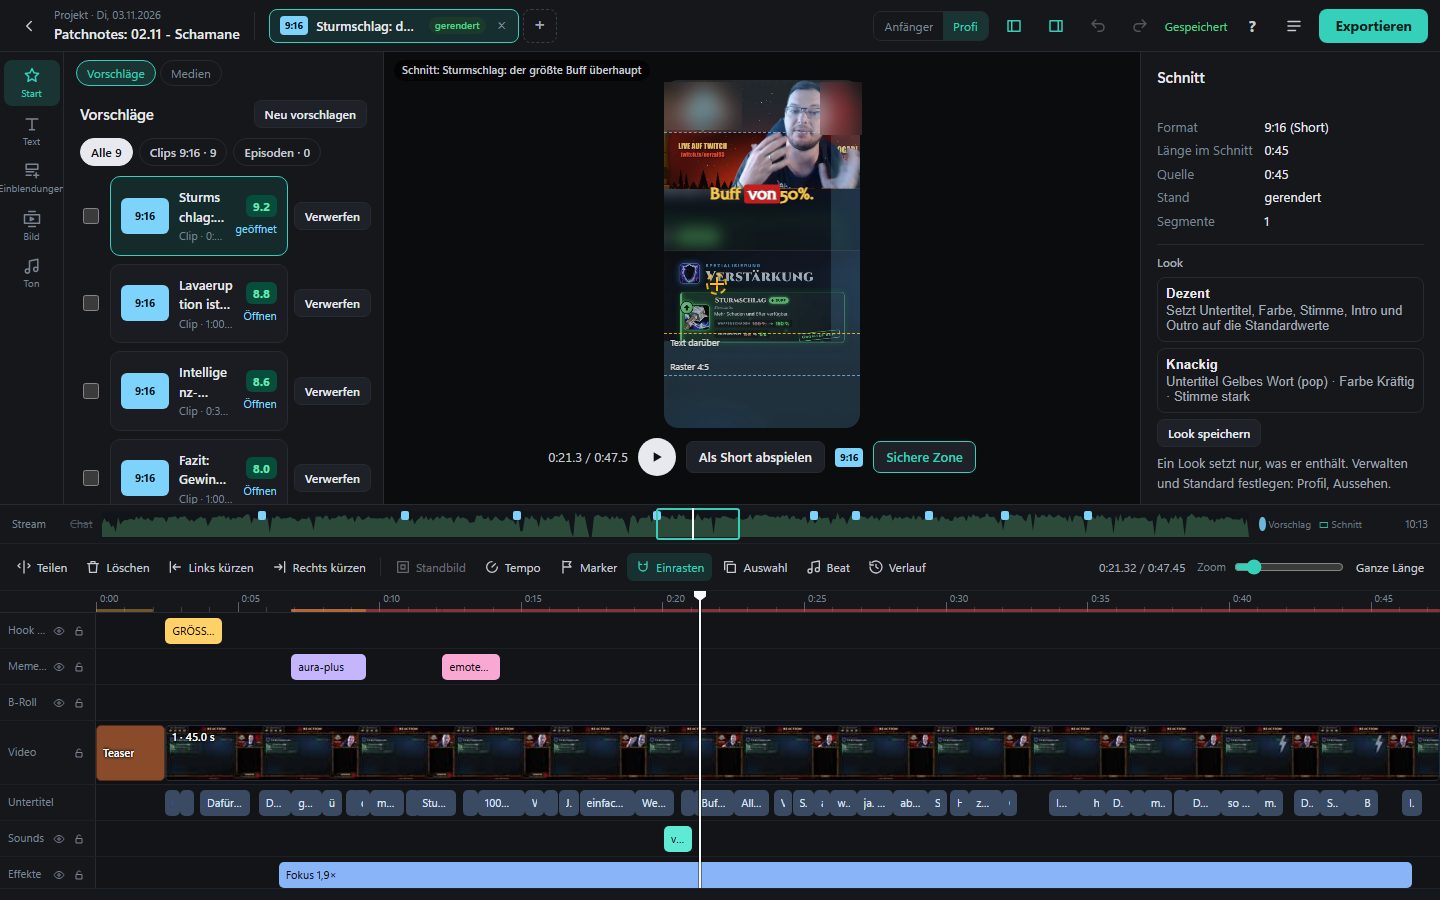
Der Projekt-Editor: der Ort, an dem das Ergebnis der Pipeline geprüft und korrigiert wird.
Stufe 1: Das VOD holen
Ein Twitch-VOD ist eine HLS-Playlist: eine Liste kurzer Mediensegmente, spezifiziert in RFC 8216. Neuroclip lädt sie selbst in Go herunter, statt einen Downloader aufzurufen. Die Gründe drehen sich alle um Fehlerbehandlung:
- Segmente werden zu mehreren gleichzeitig in einen Arbeitsordner geladen,
- ein Segment zählt erst, wenn es von einem temporären Namen umbenannt wurde, sodass ein abgebrochener Download dort weitermacht, wo er stehen geblieben ist,
- sind alle Segmente da, setzt ffmpeg sie ohne Neukodierung zusammen,
- eine kleine Metadatei wird zuletzt geschrieben, und ohne sie gilt das Video nicht als heruntergeladen.
Dieser Trick mit der zuletzt geschriebenen Metadatei ist ein billiger Commit-Marker. Jeder Code, der fragt „liegt dieses VOD lokal vor?“, schaut nach dem Marker und nie nach der großen Datei. Ein Absturz mittendrin kann also kein Video hinterlassen, das vollständig aussieht, es aber nicht ist. Das Chatlog des Streams wird daneben geholt, weil die Vorauswahl es später braucht.
Vor dem Download schätzt der Code die Größe und prüft den freien Speicherplatz mit einem Sicherheitspuffer. Ein volles Laufwerk in der dritten Stunde eines Downloads ist ein Fehler, den du lieber als Meldung vor dem ersten Byte bekommst.
Stufe 2: Audiospuren, oder warum das Mikro eine eigene bekommt
Die wertvollste Entscheidung für die Qualität der Transkription fällt in OBS, noch bevor Neuroclip ins Spiel kommt. Ich nehme mehrere Audiospuren auf: die Gesamtmischung, wie im Stream zu hören (als erste Spur, weil die meisten Clip-Werkzeuge standardmäßig den ersten Audiostream nehmen), das Mikrofon allein und das Spiel allein.
Warum ist das wichtig? Ein Spracherkennungsmodell, das Spielexplosionen, Alert-Sounds und einen Freund im Call gleichzeitig hört, rät schlechter. Ihm nur das Mikrofon zu geben, ist der billigste Genauigkeitsgewinn, den es gibt. Hat die Quelle mehr als eine Audiospur, wird die Mikrospur in eine temporäre WAV-Datei (16 kHz, mono) extrahiert; sonst bleibt es bei der Mischung. Das ist schlichtes ffmpeg, und du kannst es an deiner eigenen Aufnahme ausprobieren:
Linux / macOS
# Die 2. Audiospur (Index ab 0 gezählt) als 16-kHz-Mono-WAV extrahieren
ffmpeg -hide_banner -loglevel error -y -i stream.mkv \
  -map 0:a:1 -ac 1 -ar 16000 -c:a pcm_s16le mic.wav
Windows (PowerShell)
# Derselbe Befehl in PowerShell; der Backtick setzt die Zeile fort
ffmpeg -hide_banner -loglevel error -y -i stream.mkv `
  -map 0:a:1 -ac 1 -ar 16000 -c:a pcm_s16le mic.wav
Was deine eigene Aufnahme enthält, prüfst du mit ffprobe, das mit ffmpeg mitkommt. Der Befehl ist auf beiden Plattformen derselbe:
ffprobe -v error -select_streams a -show_entries stream=index:stream_tags=title -of compact recording.mkv
ffmpeg installieren
Wenn du den Filtergraphen unten nachvollziehen willst, brauchst du ffmpeg im PATH. Die Download-Seite listet alle Möglichkeiten.
Linux
# Debian / Ubuntu
sudo apt-get update && sudo apt-get install -y ffmpeg
macOS
# Homebrew (https://brew.sh/)
brew install ffmpeg
Windows (PowerShell)
# Windows 10/11 mit winget (Gyan.FFmpeg ist der volle Build)
winget install --id Gyan.FFmpeg -e
Stufe 3: Spracherkennung mit faster-whisper
Die Erkennung ist ein kleiner Python-Helfer, den der Go-Server als Kindprozess startet. Ich hätte ein Go-Binding für Whisper nehmen können, aber das Python-Ökosystem rund um faster-whisper (eine CTranslate2-Neuimplementierung von Whisper) liefert mir CUDA-Unterstützung und Wort-Zeitstempel mit dem wenigsten Code. Er läuft auf der GPU und fällt auf ein langsameres, ungenaueres CPU-Modell zurück, wenn kein nutzbarer GPU-Stack da ist: Es soll überall laufen und dort gut sein, wo es kann.
Drei Ideen tragen den Großteil der Qualität:
- Wort-Zeitstempel sind der ganze Grund für diesen Weg. Die Wort-für-Wort-Hervorhebung im fertigen Video braucht Start und Ende pro Wort, nicht pro Satz.
- Sprachaktivitätserkennung läuft zuerst, damit aus Stille und Spielgeräuschen keine erfundenen Wörter werden.
- Ein Vokabel-Prompt aus Figurennamen und Fachjargon des Spiels. Whisper ist ein Sprachmodell; ihm zu sagen, welche ungewöhnlichen Wörter kommen, hilft mehr als jede Nachbearbeitung. Eine Liste manueller Korrekturen fängt Namen ab, die es trotzdem falsch schreibt.
Die Erkennung läuft als Strom von Segmenten, der Helfer kann also bei einer langen Aufnahme Fortschritt melden. Das Ergebnis ist eine Cue-Liste: ein Eintrag pro Untertitelzeile mit Text sowie Start und Ende jedes Wortes, als ein gemeinsamer Go-Typ zwischen Transkription und Renderer. Ich habe keine Reihe von Modellen verglichen und nenne deshalb keine Zahlen.
Stufe 4: Kandidaten wählen ohne LLM
Welche 45 Sekunden eines vierstündigen Streams verdienen einen Short? Ein Weg ist, Claude das Transkript lesen und Fenster bewerten zu lassen, und Neuroclip kann das. Es kostet aber pro Lauf Geld und hat einen Fehlerfall, der mir nicht gefiel: Ist die API nicht erreichbar oder das Budget erreicht, ist das ganze Feature tot.
Deshalb ist die Vorauswahl schlichtes, deterministisches Go. Sie führt voneinander unabhängige Signale über den Stream zu einer Rangliste zusammen, jeder Moment mit einer Wertung und einer Begründung in Worten:
- wie laut und aufgeregt ein Audioabschnitt ist,
- Schlagwörter im Transkript,
- Ausschläge der Chat-Aktivität,
- Momente, die ich beim Streamen selbst markiert habe (siehe Teil 3),
- Clips, die Zuschauer auf Twitch gemacht haben.
Jedes Signal geht mit eigenem Gewicht ein. Signale, die zeitlich dicht beieinanderliegen, zählen als ein Moment, und ein Moment, den mehrere verschiedene Signalarten bestätigen, steht höher als einer mit nur einem starken Signal. Die Gewichte sind benannte Konstanten im Code, Feinabstimmung ist also eine reviewbare Änderung und kein Prompt-Experiment.
Das Chat-Signal ist das spannende. Der Chat reagiert ein paar Sekunden nach dem Ereignis, deshalb werden die Nachrichtenzeiten zurückgeschoben. Ein Ausbruch wird am lokalen Niveau der Chat-Aktivität gemessen, nicht an einem globalen Schwellwert. So wird ein ruhiger Stream mit plötzlichem Ausbruch genauso erkannt wie ein belebter. Wenn du etwas Ähnliches baust, stimme die Zahlen auf dein eigenes Publikum ab.
Auch die Vorschlagsschwelle ist nicht fest. Sie startet bei einem Standardwert und passt sich an das an, was ich tatsächlich fertigstelle und was ich verwerfe. Was ein Mensch von Hand gewählt hat, ein Marker oder ein Zuschauer-Clip, wird immer vorgeschlagen, unabhängig von der Wertung.
Claude ist eine optionale Schicht obendrauf. Mit Claude hängt die Vorauswahl nur ihre Begründungen an die Kandidaten, und Claude bewertet; ohne Claude zeigt der Editor direkt die regelbasierte Liste. Beide Wege enden im selben Editor, und die Begründungen sind einfache Sätze, die Liste erklärt sich also selbst.
Stufe 5: Von 16:9 auf 9:16
Ein Stream ist 1920 x 1080 mit der Facecam irgendwo im Bild. Ein Short ist 1080 x 1920. Das Layout ist der Klassiker: Facecam-Streifen oben, Gameplay darunter.
Zwei Rechtecke beschreiben das Layout, und woher sie kommen, folgt einer Rangfolge: Eine ausdrückliche Wahl für diesen Render gewinnt, dann das für genau diesen Stream gespeicherte Layout, dann der Profil-Standard. Der mittlere Punkt existiert, weil ich mein Stream-Overlay im Lauf der Zeit geändert habe. Ein Short aus einem älteren Stream mit dem heutigen Profil-Rahmen würde ein abgeschnittenes Gesicht zeigen, deshalb wird das Layout einmal pro Stream festgehalten.
Der Filtergraph
Der Renderer baut einen ffmpeg--filter_complex-String aus Zahlen und festen Bausteinen zusammen. Lies das Folgende als Pipeline: split dupliziert das Video, jede Kopie wird auf ihren Rahmen zugeschnitten und auf volle Breite skaliert, und vstack stapelt die beiden Streifen. Beide Streifen brauchen gerade Abmessungen, weil H.264 mit 4:2:0-Chroma-Subsampling das verlangt. Dieses generische Beispiel nutzt Zahlen zur Illustration für einen 480 x 270 großen Webcam-Rahmen oben rechts und einen annähernd hochformatigen Spielrahmen:
Linux / macOS
ffmpeg -ss 600 -t 30 -i vod.mp4 -filter_complex \
  "[0:v]split=2[a][b];[a]crop=480:270:1440:0,scale=1080:608[c];[b]crop=880:1070:100:5,scale=1080:1312[g];[c][g]vstack" \
  -c:v libx264 -crf 20 -preset veryfast -pix_fmt yuv420p -c:a aac short.mp4
Windows (PowerShell)
ffmpeg -ss 600 -t 30 -i vod.mp4 -filter_complex `
  "[0:v]split=2[a][b];[a]crop=480:270:1440:0,scale=1080:608[c];[b]crop=880:1070:100:5,scale=1080:1312[g];[c][g]vstack" `
  -c:v libx264 -crf 20 -preset veryfast -pix_fmt yuv420p -c:a aac short.mp4
(608 + 1312 = 1920. Ersetze libx264 durch h264_nvenc, wenn du eine NVIDIA-GPU hast.)
Zwei Verfeinerungen sind wissenswert:
- Toleranz beim Seitenverhältnis. Hat der Spielrahmen ungefähr die Form seines Streifens, wird er einfach zugeschnitten und skaliert. Hat er eine ganz andere Form, wird er verzerrungsfrei eingepasst in die Mitte des Streifens, und der Rest des Streifens zeigt dasselbe Bild vergrößert, weichgezeichnet (
boxblur) und abgedunkelt. Das ist der bekannte Look mit unscharfem Hintergrund, gebaut aus demselben Filter-Vokabular. - Lange Graphen landen in einer Datei. Mit Effekten und Overlays kann der String lang werden. Dann ist es besser, ihn in eine Datei zu legen und die an ffmpeg zu übergeben, als an Kommandozeilen-Grenzen zu stoßen. Seit ffmpeg 7.0 geht das über die allgemeine Syntax
-/option datei, hier also-/filter_complex graph.txt; das ältere-filter_complex_scriptfunktioniert noch, ist aber veraltet.
Weil der Prozess mit einer Argumentliste statt über eine Shell startet und der Graph aus Zahlen und festen Bausteinen entsteht, gibt es nichts, wo eine bösartige Eingabe etwas einschleusen könnte. Benutzertext, der in der Untertiteldatei landet, wird mit derselben Sorgfalt behandelt, womit wir bei den Untertiteln sind.
Wortgenaue Untertitel in ASS
Die eingebrannten Untertitel sind ein Advanced-SubStation-Alpha-Skript (ASS), das der ffmpeg-Filter ass rendert. Ich habe ASS statt SRT gewählt, weil ASS einzelne Ereignisse gestalten, Text frei positionieren und eine Box hinter ein Wort zeichnen kann, SRT nicht. Der Builder schreibt ein Ereignis pro gesprochenem Wort: Der Textblock steht für die Dauer seiner Zeile, und in der Zeitspanne jedes Wortes bekommt genau dieses Wort die Hervorhebung. Hervorhebungsstil, Schrift und Farben sind einstellbar.
Alles, was ein Nutzer tippen kann, landet in diesem Skript, und ASS hat eine eigene Steuersyntax: { startet Override-Tags und ein Backslash leitet eine Escape-Sequenz ein. Deshalb wird Text bereinigt, bevor er in ein Ereignis gelangt, und Stil-Overrides werden geprüft. Das ist Eingabe-Bereinigung für ein Format, das niemand als Angriffsfläche betrachtet, bis die Chat-Nachricht eines Zuschauers darin landet.
Die Sichere Zone
Vertikale Plattformen verdecken Teile des Bildes mit ihrer eigenen Oberfläche: oben eine Kopfzeile, seitlich Buttons, unten Bedienelemente. Eingebrannter Text muss diese Bereiche freihalten, deshalb zeichnet der Editor ein Overlay mit der sicheren Zone. Die Ränder sind meine eigenen Arbeitswerte für die Plattformen, auf denen ich poste, keine offizielle Spezifikation. Prüfe also die aktuellen Richtlinien deiner Plattform.
Stufe 6: Hardware-Kodierung, und was bei Fehlern passiert
NVENC ist der Hardware-Encoder auf NVIDIA-GPUs; er nimmt die Kodierlast von einer CPU, die ohnehin ein Spiel betreibt. Der Renderer probiert zuerst den GPU-Encoder und hat einen passenden x264-Rückfall.
Die Robustheit steckt in der Wiederholungsregel. Schlägt NVENC fehl, versucht der Renderer es mit x264 erneut, aber nur, wenn die GPU plausibel schuld ist: Die Fehlerausgabe von ffmpeg erwähnt den Encoder, CUDA oder den Treiber, oder es gibt gar keine Meldung, was meist heißt, dass der Prozess beendet wurde. Geht es im Fehler um den Filtergraphen oder eine fehlende Datei, würde ein zweiter Versuch mit x264 identisch scheitern, nach Minuten an Arbeit, also bricht er sofort ab. Auch ein abgebrochener Job wird nicht wiederholt: Das ist keine fehlende GPU. Eine billige Prüfung, die ein paar Bilder eines erzeugten Testbilds kodiert, sagt dem Programm einmalig, ob Hardware-Kodierung überhaupt verfügbar ist.
Nach dem Rendern misst ein zweiter Durchgang die Lautheit des Shorts und wendet, wenn sie deutlich vom Ziel abweicht, eine einzige lineare Verstärkung an, während das Bild ohne Neukodierung kopiert wird. Dieser Durchgang darf scheitern: Ein Fehler wird zu einem Hinweis, nicht zu einem Fehler des Renders.
Wie Go externe Prozesse robust steuert
All das nützt nichts, wenn ein Render ewig hängen, eine kaputte Datei hinterlassen oder das Spiel einfrieren kann, das du gerade streamst. Das sind allgemeine Muster, die für jedes Werkzeug funktionieren, das ffmpeg umhüllt.
1. Context-Abbruch überall. Nutze exec.CommandContext, dann beendet der Abbruch des Contexts ffmpeg. Gib für einen abgebrochenen Lauf immer einen bekannten Fehler zurück, damit Aufrufer „der Nutzer hat abgebrochen“ nicht mit „der Encoder ist kaputt“ verwechseln.
2. Part-Dateien und atomares Umbenennen. Schreibe unter einem temporären Namen und benenne erst auf den echten Namen um, nachdem ffmpeg mit 0 beendet wurde. Bei jedem Fehler oder Abbruch wird die Part-Datei gelöscht und die vorherige Ausgabe bleibt. Nichts weiter hinten kann eine halb kodierte Datei für eine fertige halten. Behalte die ursprüngliche Endung im temporären Namen, denn ffmpeg wählt den Muxer anhand der Endung.
3. Fortschritt ohne stderr-Scraping. ffmpeg kann maschinenlesbaren Fortschritt mit -progress <datei> -nostats in eine Datei schreiben. Lies diese Key=Value-Datei regelmäßig und teile die Ausgabezeit durch die erwartete Länge, dann hast du einen Anteil von 0 bis 1 für die Oberfläche.
out_time_us=12480000
out_time_ms=12480000
progress=continue
(out_time_ms ist trotz des Namens ebenfalls in Mikrosekunden.)
4. Hintergrundpriorität. Läuft das Werkzeug auf dem Streaming-PC selbst, sollen Renders OBS und dem Spiel weichen. Kinder erben die Priorität ihres Elternprozesses, wer sie für die gestarteten Prozesse senkt, erwischt also auch einen Python-Helfer, der ffmpeg startet. Unter Windows ist das ein Flag beim Prozessstart; unter Linux kannst du den Befehl in nice packen. Auch ffmpegs eigene Thread-Begrenzungen helfen.
5. Prozesse ohne Shell. Starte Werkzeuge mit exec.Command(name, args...), nie über eine Shell, und leite ihre Ausgabe in ein Log, dem deine Oberfläche folgen kann. Beende beim Herunterfahren alle Kinder und warte auf sie, damit kein Helfer den Server überlebt und weiter Dateien schreibt. Unter Windows beendest du den ganzen Prozessbaum.
6. Panics beenden den Prozess nicht. Starte Goroutinen über einen Wrapper, der Panics abfängt und den Besitzer informiert, damit der Zustand zurückgesetzt werden kann. Ein hängendes Flag „Stream endet“ würde sonst den nächsten Lauf blockieren.
Die Standardbibliothek erledigt das meiste: os/exec, context und os.Rename. Wie man so eine Binärdatei ausliefert, steht in meinem Go-und-Docker-Beitrag.
Stufe 7: Abnahme und Prüfungen
Ein Render ist nicht fertig, wenn ffmpeg endet. Nach dem Entstehen eines Shorts schauen automatische Qualitätsprüfungen auf den Schnitt, den fertigen Render, den Kamera-Ausschnitt und die Lautheit. Jede liefert ok, Warnung, Problem oder „konnte nicht laufen“, und das Dashboard verdichtet sie zu einer Ampel.
Die Kernregel im Design: Eine Prüfung ist ein weicher Schritt. Eine fehlschlagende oder fehlende Prüfung lässt den Job nie scheitern. Ein kaputter Prüfer soll mich nicht daran hindern, das Video zu sehen.
Shorts sind nur das erste von zwei Produkten. Dieselben Bausteine speisen eine Pipeline für längere YouTube-Episoden, und eine Entscheidung dort zeigt die Haltung: Shorts brennen die Untertitel ein, Episoden liefern eine Untertitel-Spur, weil eingebrannter Text bei langen Videos stört und YouTube Untertitelspuren indexiert.
Was noch holprig ist
- Das Projekt ist Early Access und Single-User. Jeder Pfad oben wurde auf meiner Maschine mit meinem Overlay und meinen Aufnahmen durchlaufen. Auf anderen Setups habe ich es nicht überprüft.
- Der Code für Filtergraph und Untertitel ist organisch gewachsen. Er hat Tests, aber es ist die erste Stelle, die ich umbauen würde.
- Die Spracherkennung ist nur so gut wie die Mikrospur und der Vokabel-Prompt. Ungewöhnliche Namen brauchen weiterhin manuelle Korrekturen.
Wie es weitergeht
Als Nächstes geht es um den Teil, der den Stream selbst zu Daten macht: Teil 3 behandelt die OBS-Regie, die Schaltzentrale, die mit OBS spricht, Alarme auslöst und die Marker schreibt, die diese Pipeline so hoch bewertet. Wenn du das Ganze lieber sehen als lesen willst, findest du Details und die Early-Access-Warteliste auf der Neuroclip-Seite.